FlashDrop
4가지 동시성 전략으로 초과 발급 없는 선착순 쿠폰 발급을 구현하고 k6로 측정해 비교
이 프로젝트가 증명하는 것
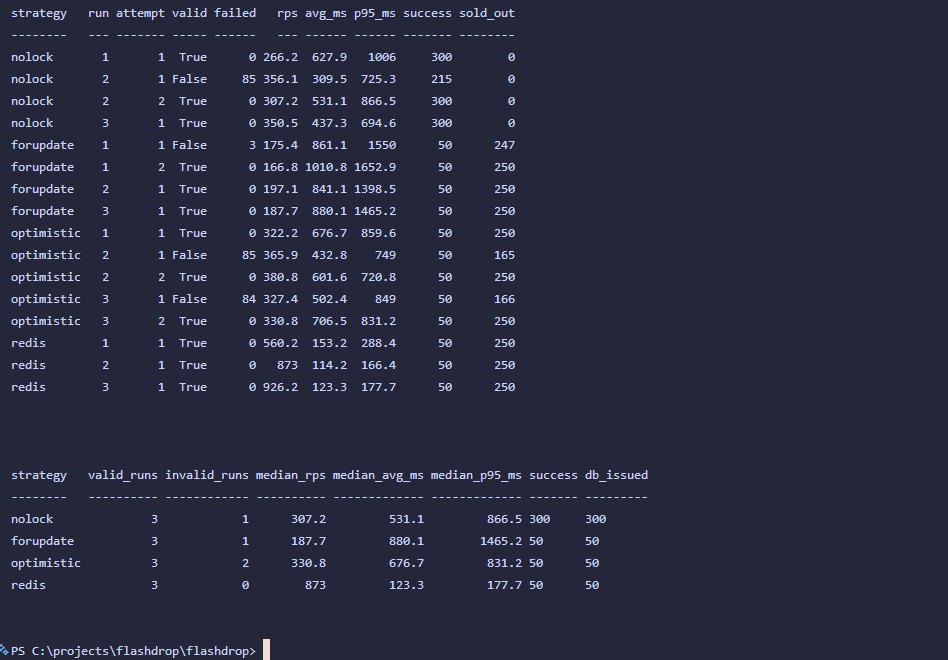
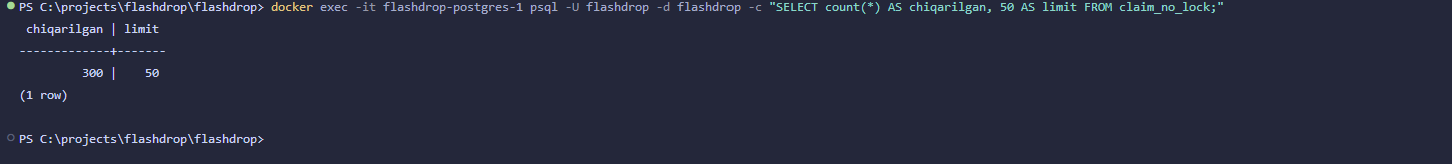
- 문제를 숫자로 증명: 락 없음 방식이 50장 대신 300장을 발급했고, remaining_quantity는 0이 아니라 46에 머물렀습니다
- 올바른 해법 3가지: 나머지 세 방식은 300건 중 정확히 50건만 통과시켰고 DB에도 정확히 50행
- 결과를 설명: 이 부하에서 낙관적 락이 FOR UPDATE보다 빨랐던 이유를 찾았습니다. FOR UPDATE는 거절될 250건까지 줄 세웁니다
- 측정 규율: warm-up, 3회 중앙값, TCP backlog로 일부 거부된 실행은 자동 무효. 재측정이 결론을 뒤집자 README를 고쳤습니다
- 운영: SHA 태그 배포와 rollback, 매일 백업과 복원 시험, 충돌 표시가 배포된 사고 뒤 넣은 배포 보호 장치
- 역할
- 단독 개발: 설계, 백엔드, 테스트, 부하 테스트, 프론트엔드, 배포와 운영 (커밋 21개)
- 기간
- 2026.09 – 2026.10
- 기술 스택
- Java
- Spring Boot
- Spring Data JPA
- PostgreSQL
- Redis
- Lua
- Flyway
- Bucket4j
- JUnit 5
- Testcontainers
- k6
- Docker
- Caddy
- Cloudflare
핵심 수치
해결하려는 문제
쿠폰 50장에 동시 요청 300건이 몰려도 한 장도 초과 발급되면 안 됩니다. 단순한 '읽기 → 확인 → 쓰기'는 lost update 때문에 50장 대신 300장을 발급합니다. 같은 비즈니스 규칙을 4가지 방식으로 구현해, 실제 부하에서 정확성, 처리량, 지연 시간의 균형을 측정해야 했습니다.
아키텍처
Caddy가 정적 프론트엔드를 제공하고 /api/* 요청을 Spring Boot로 넘깁니다. 요청은 먼저 Bucket4j 레이트 리미터(상태는 Redis)를 통과합니다. 전략마다 엔드포인트, 엔티티, 테이블이 따로 있습니다. Redis 방식은 남은 수량과 '받은 사용자' 집합을 Lua 스크립트 하나에서 원자적으로 확인하고, PostgreSQL 기록은 @Async로 백그라운드에서 처리합니다.
데이터 모델
핵심 제약 조건과 인덱스
- campaign_*.code VARCHAR(50) NOT NULL UNIQUE
- claim_*: UNIQUE (campaign_id, user_id): 중복 발급을 DB에서 차단하고 existsByCampaignIdAndUserId 조회를 빠르게 함
- campaign_optimistic.version BIGINT NOT NULL DEFAULT 0: @Version 낙관적 락
- V9 CHECK (remaining_quantity >= 0): for_update, optimistic, redis에만 적용 (no_lock은 oversell이 보이도록 일부러 제외)
- claim_redis.id UUID: 앱에서 생성해 DB 기록을 기다리지 않고 응답
- Redis 키 (claim.lua): stock(DECR), claimed set(SADD). 결과 1 발급, 0 품절, -1 캠페인 없음, -2 이미 받음
핵심 설계 결정
Redis: Lua에서 DECR + SADD, DB 기록은 @Async
- 상황
- FOR UPDATE는 모든 요청을 hot row 하나 앞에 줄 세웠습니다(p95 1,465ms).
- 결정
- SISMEMBER → GET → DECR + SADD를 claim.lua 하나에서 실행해 hot path에 Postgres도, check-then-act 틈도 없습니다.
- 트레이드오프
- Redis와 DB 사이에서 프로세스가 죽으면 쿠폰이 DB에서 사라질 수 있습니다.
낙관적 락의 재시도를 두 빈으로 분리
- 상황
- @Transactional 프록시는 self-invocation을 가로채지 못해, 한 클래스에 두면 트랜잭션이 실제로 적용되지 않습니다.
- 결정
- OptimisticClaimService(재시도, 최대 20회) → OptimisticClaimAttempt(@Transactional, @Version)
- 트레이드오프
- 하나의 로직이 두 클래스로 나뉩니다.
전략마다 별도 테이블과 엔드포인트
- 상황
- k6 결과가 서로 섞이면 안 됩니다.
- 결정
- 4가지 전략이 각자의 campaign / claim 테이블, 엔티티, 엔드포인트를 갖습니다.
- 트레이드오프
- 코드와 마이그레이션이 중복됩니다(테이블 8개).
락 없음 방식을 일부러 남김
- 상황
- 문제를 숫자로 보여 주기 위해서입니다.
- 결정
- lost update가 그대로 일어나는 엔드포인트를 유지하고, 해당 테이블에는 CHECK 제약도 두지 않았습니다.
- 트레이드오프
- 프로덕션에서는 이런 엔드포인트를 두지 않습니다.
멱등성과 재고 하한을 DB에서: UNIQUE(campaign_id, user_id), CHECK (remaining_quantity >= 0)
- 상황
- 앱 로직이 틀려도 두 번 발급하거나 재고가 음수가 되면 안 됩니다.
- 결정
- 모든 claim 테이블에 UNIQUE를, 세 개의 올바른 전략에 V9 CHECK를 걸었습니다. 프로덕션에서 remaining_quantity = -1 갱신이 거부된 것을 확인했습니다.
- 트레이드오프
- Redis 전략은 Redis와 DB 두 곳에서 검사합니다.
레이트 리밋 키는 userId
- 상황
- 프로젝트에 있는 유일한 식별자입니다.
- 결정
- Bucket4j + Redis(Lettuce) 토큰 버킷을 userId 기준으로 적용해, 인스턴스가 여러 개여도 한도를 공유합니다.
- 트레이드오프
- 클라이언트가 바꿀 수 있는 값이라 프로덕션에서는 IP와 함께 써야 합니다.
개선 전후 측정
- 무엇을 바꿨나
- 처음 표는 JIT와 커넥션 풀이 준비되지 않은 차가운 1회 실행이었습니다. scripts/bench.ps1에 warm-up, 3회 실행, 중앙값, 유효성 규칙(성공 + 품절 < 300이면 무효)을 넣고 다시 재자 두 결론이 뒤집혔습니다. 락 없음은 '가장 느림'이 아니라 '빠르지만 틀림'(80.4 → 307 rps)이었고, 낙관적 락은 '가장 느림'이 아니라 FOR UPDATE보다 1.76배 빨랐습니다(114.1 → 331 rps). 이유는 findByCodeForUpdate가 남은 수량을 확인하기 전에 락을 잡기 때문입니다. 개선책(락 전에 일반 SELECT로 품절 확인)은 아직 적용하지 않았습니다.
장애 대응 기록
- 증상
- 2026-10-09 배포 후 flashdrop.javohir.dev UI가 깨지고 페이지에 <<<<<<< HEAD 문자열이 그대로 나왔습니다.
- 원인
- 로컬 저장소가 GitHub보다 뒤처져 push가 거부됐고, git pull 병합에서 4개 파일에 충돌이 났는데 표시를 지우지 않은 채 커밋됐습니다. 프론트엔드는 Caddy가 git 작업 디렉터리에서 바로 제공했기 때문에 git pull 즉시 프로덕션에 반영됐고, 백엔드 rollback은 프론트엔드를 되돌리지 못했습니다.
- 해결
- 마지막으로 정상 동작한 커밋에서 frontend/index.html을 복구하고 README를 다시 쓴 뒤, 실수로 커밋된 IDE 빌드 산출물(bin/)을 지우고 .gitignore에 추가해 다시 배포했습니다 (7ac0754).
- 재발 방지
- deploy.sh가 git grep으로 upstream의 충돌 표시를 검사하고, 발견하면 배포를 멈춥니다. 병합은 --ff-only로만 합니다 (a2dd204). 숨은 후유증도 찾았습니다: 충돌을 고칠 때 README(ko/en/uz)가 예전 차가운 실행 표로 돌아가 있었고, 포트폴리오 문서를 repo와 대조하다 발견해 재측정 결과로 복구했습니다 (a29c567).
테스트와 품질
- 테스트 수
- 4
- 커버리지
- —
- CI
- —
- 테스트 도구
- JUnit 5, Testcontainers (PostgreSQL 17, Redis 7), virtual threads, k6, bench.ps1
배포와 운영
- 배포 환경
- iwinv VPS, Docker Compose: app(Spring Boot, non-root, 메모리 1GB 제한), web(Caddy: 정적 콘솔 + /api/* 프록시), PostgreSQL 17, Redis 7, seed(데모 캠페인). DB와 Redis 포트는 외부에 열지 않습니다. deploy.sh: 충돌 표시 검사 → git merge --ff-only → 이미지를 SHA 태그로도 빌드 → app과 web 갱신, SHA를 .deploy-history에 기록. HikariCP 50, Tomcat accept-count 500.
- 백업
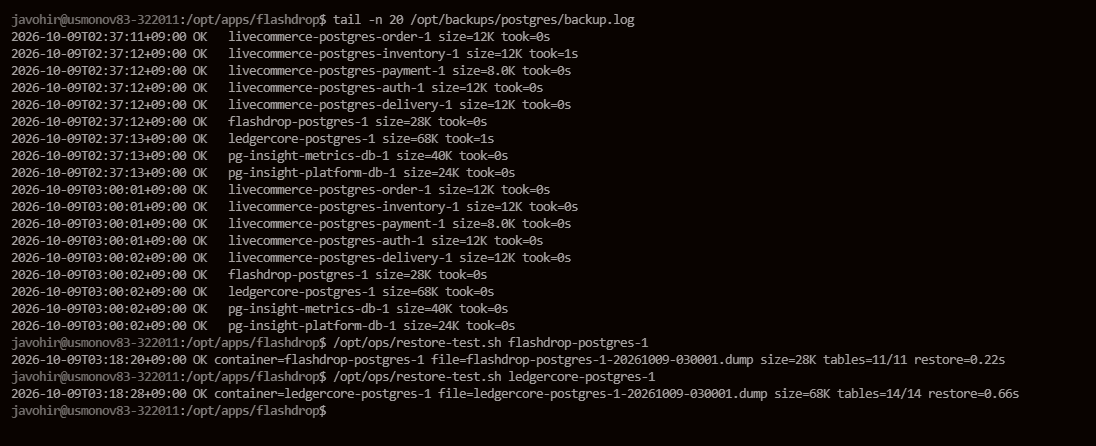
- 매일 03:00(KST) cron으로 pg_dump, 7일 보관, 서버의 Postgres 9개 모두 대상. 2026-10-09 03:00 자동 실행 확인. 복원 시험: FlashDrop 0.22초(11/11 테이블), LedgerCore 0.66초(14/14 테이블)
- 롤백
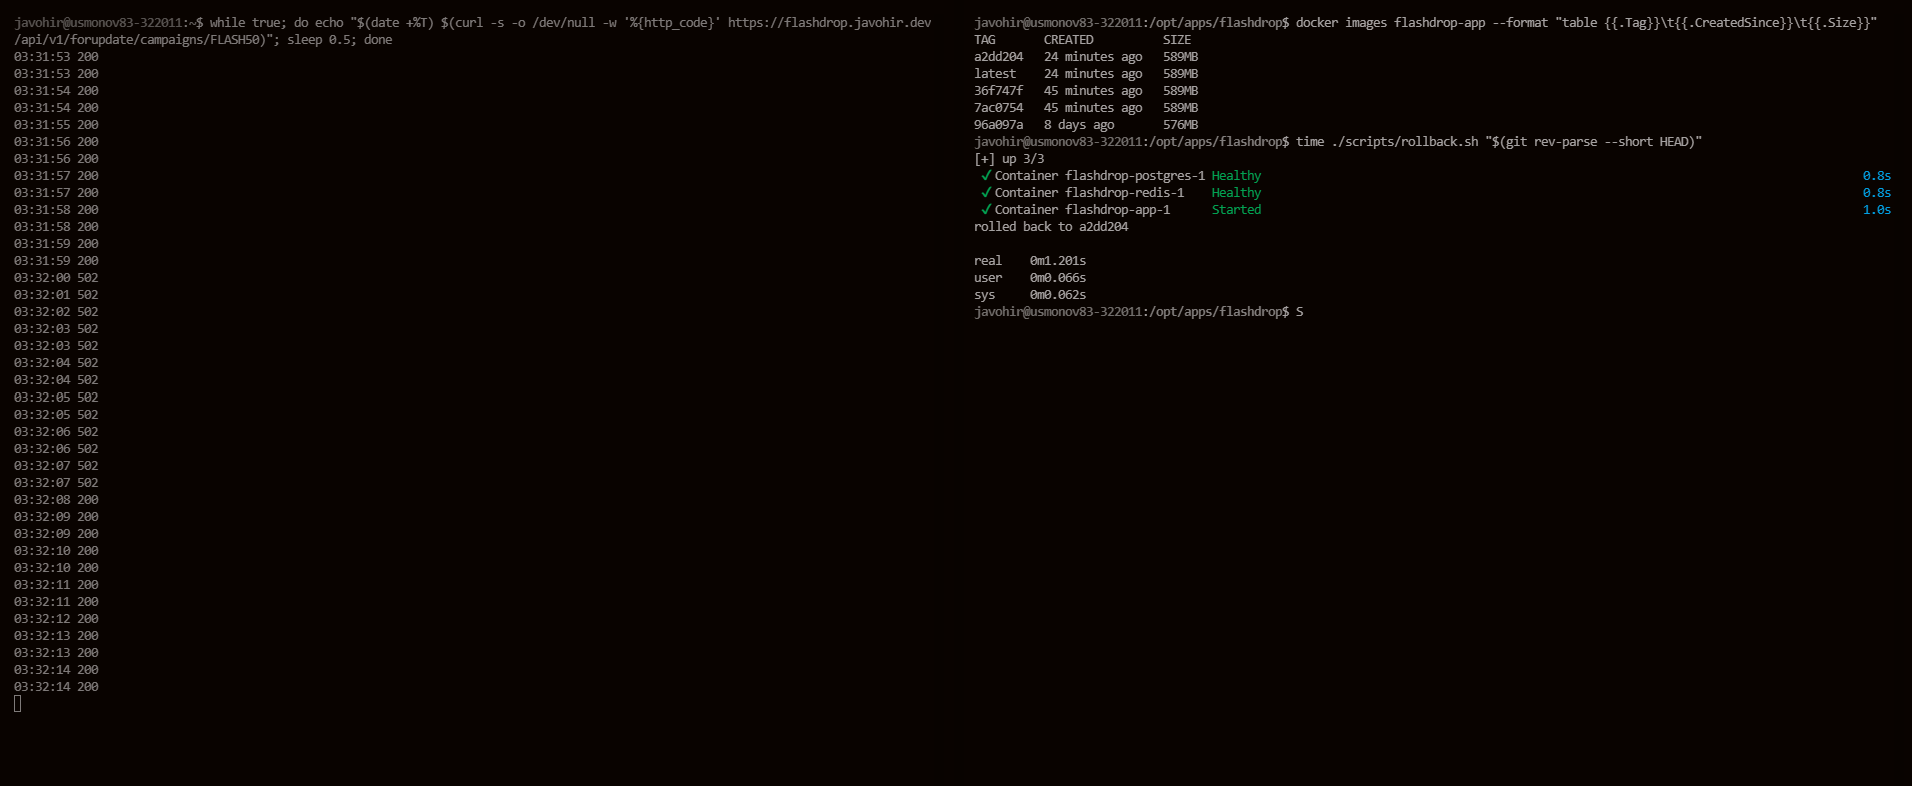
- rollback.sh는 이전 SHA 이미지를 latest로 지정해 빌드 없이 app을 다시 만듭니다. 프로덕션에서 명령은 real 0m1.201s, 외부에서 보면 03:32:00–03:32:07 동안 502 뒤 다시 200이었습니다.
- 모니터링
- pg_stat_statements 활성화, 모니터링 네트워크로 PG Insight에 연결
스크린샷
한계와 회고
현재 한계
- Redis와 Postgres 사이의 공백: Redis에서는 발급됐는데 @Async 기록 전에 앱이 죽으면 Postgres에는 없습니다. @Async 오류는 사라지고(handler 없음), executor 큐(500)가 차면 DECR 뒤에 TaskRejectedException이 납니다. campaign_redis.remaining_quantity는 init 뒤 동기화되지 않고 reconciliation job도 없습니다
- FOR UPDATE 경로가 최적이 아닙니다: 남은 수량 확인 전에 락을 잡아 거절될 요청도 줄을 섭니다. 락 전 일반 SELECT는 아직 넣지 않았습니다
- 레이트 리밋 키가 약합니다: userId는 클라이언트가 바꿀 수 있어 프로덕션에서는 IP와 함께 써야 합니다
- 테스트가 적습니다: 동시성 테스트 4개뿐이고 단위·HTTP 테스트가 없습니다. NoLockConcurrencyTest는 일부러 빨간색이라 gradlew test가 완전히 초록이 되지 않습니다
- 단일 인스턴스: rollback 명령은 1.2초지만 JVM이 뜰 때까지 약 8초 502가 납니다. health 기반 단계적 전환이 없고 배포도 health를 기다리지 않으며, 백업이 DB와 같은 디스크에 있습니다
- 측정 환경: 노트북 한 대(Windows + Docker Desktop, i7-8565U)에서 잰 값이며, OS listen backlog가 일부 실행에서 요청을 거부했습니다
- 콘솔 카운터는 브라우저 세션 기준이라 새로고침하면 0이 되고, 공통 메트릭 엔드포인트가 없습니다
다시 만든다면
- 처음부터 Redis Stream이나 Outbox로 백그라운드 기록: DB 커밋 뒤에만 ACK, 유실된 메시지는 다시 읽고, reconciliation job 추가
- 첫날부터 CI(테스트, 충돌 검사, 작은 k6 smoke), 프론트엔드를 이미지에 포함하고 health check 기반 blue-green 배포
핵심 코드
src/main/java/com/flashdrop/strategy/nolock/NoLockClaimService.java일부러 만든 lost update: 락 없이 읽기 → 확인 → 쓰기
src/main/java/com/flashdrop/strategy/forupdate/ForUpdateCampaignRepository.java@Lock(PESSIMISTIC_WRITE) findByCodeForUpdate
src/main/java/com/flashdrop/strategy/optimistic/OptimisticClaimAttempt.javaself-invocation을 피하려고 별도 빈으로 뺀 트랜잭션
src/main/resources/scripts/claim.lua중복, 남은 수량, 차감을 원자적 연산 하나로
src/main/java/com/flashdrop/strategy/redis/RedisClaimService.javaLua 결과 코드를 비즈니스 상태로 바꾸고 DB 기록을 백그라운드로
src/main/java/com/flashdrop/strategy/redis/RedisClaimWriteBackService.javaPostgres에 @Async로 나중에 기록
src/main/java/com/flashdrop/ratelimit/RateLimitInterceptor.javaBucket4j + Redis 토큰 버킷, 429와 Retry-After
scripts/bench.ps1warm-up, 3회, 중앙값, 무효 실행 재실행
scripts/deploy.sh, scripts/rollback.sh충돌 검사, SHA 태그 이미지, rollback
현재 상태와 다음 단계
락 없음 방식은 50장 대신 300장을 발급했고(remaining_quantity는 0이 아니라 46), 나머지 세 방식은 300건 중 정확히 50건만 통과시켜 DB에도 정확히 50행이 남았습니다. Redis 방식은 FOR UPDATE보다 처리량 4.6배, p95 8.2배 좋았습니다. 수치는 warm-up 1회 뒤 유효한 3회의 중앙값이며, 성공 + 품절 합계가 300보다 적은 실행(TCP backlog로 일부 거부)은 자동으로 무효 처리하고 다시 실행했습니다. 레이트 리밋은 같은 userId로 12건 중 6건 통과, 6건 429(토큰 5개 + greedy refill)였습니다.